


Deutsch | Español | français | 日本語 | 한국어 | Português | Русский | 中文
LocalAI es el motor de IA de código abierto. Ejecuta cualquier modelo - LLMs, visión, voz, imagen, vídeo - en cualquier hardware. No requiere GPU.
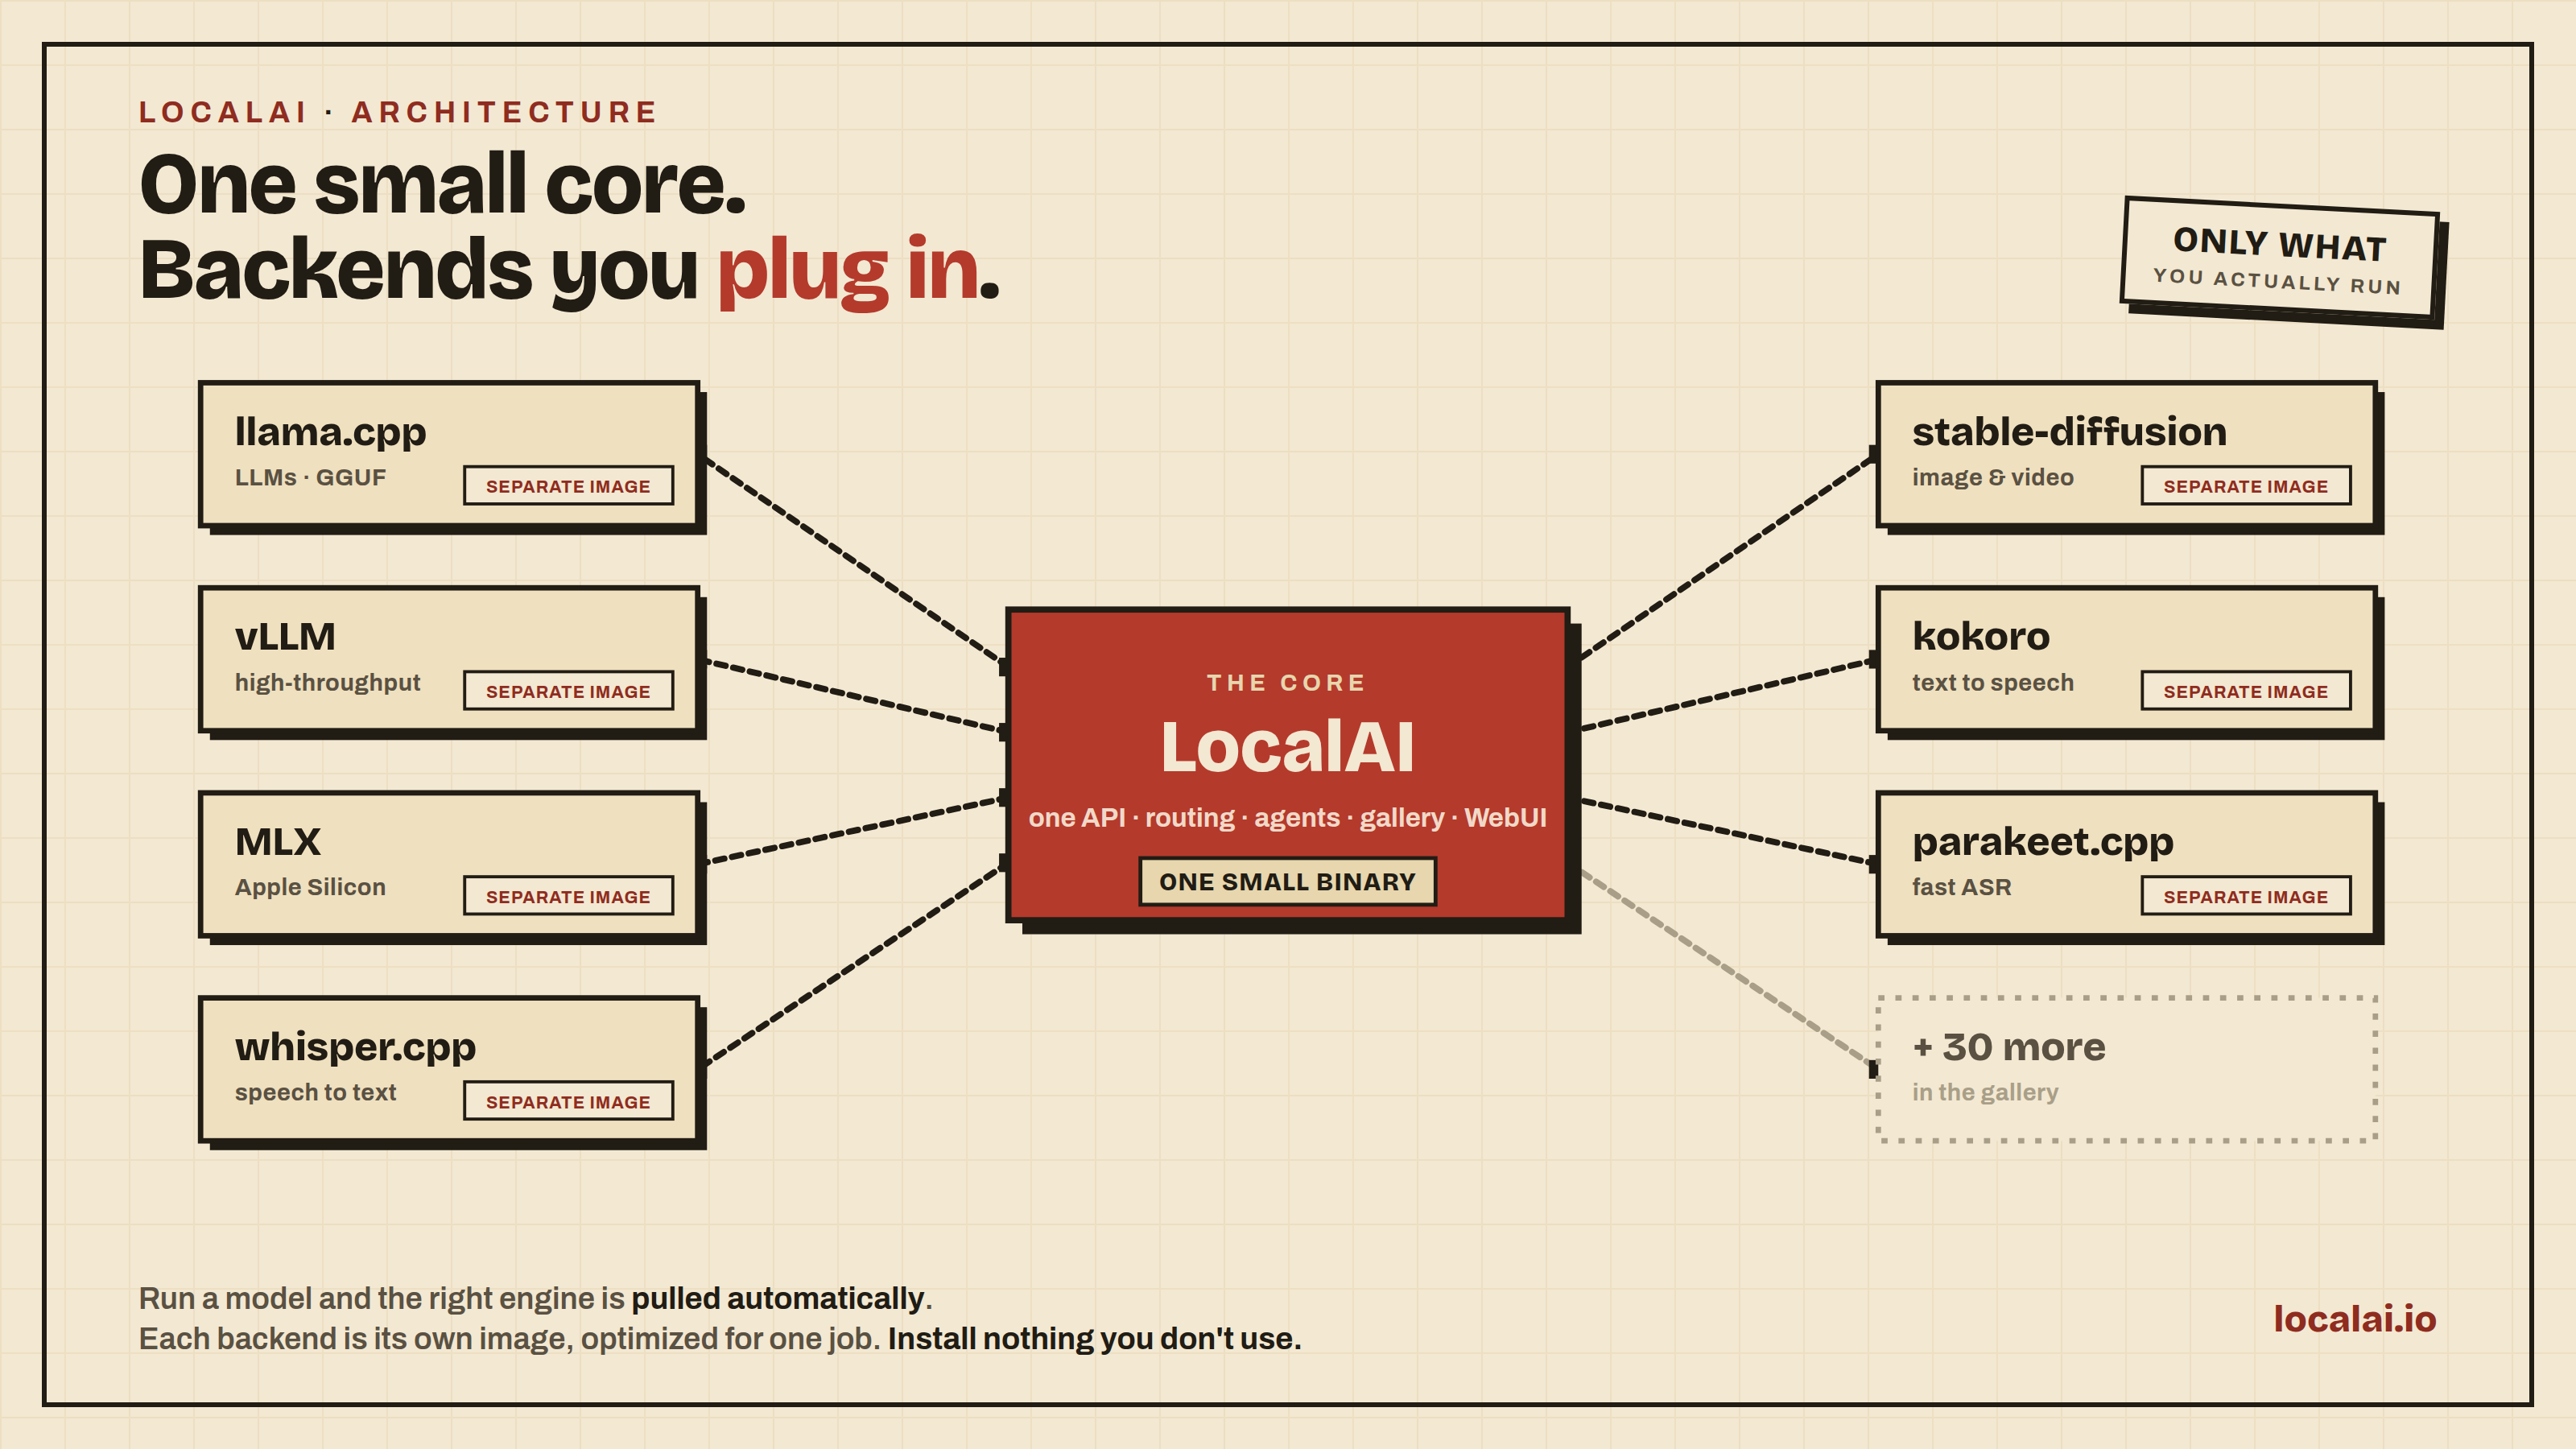
Un núcleo pequeño, no un paquete completo. Cada backend envuelve un motor de primer nivel (llama.cpp, vLLM, whisper.cpp, stable-diffusion, MLX...) en su propia imagen, que se descarga solo cuando un modelo la necesita. No instalas nada que no uses.
- Composable by design: los backends son independientes y se traen bajo demanda, por lo que instalas solo lo que tu modelo necesita
- Open and extensible: carga cualquier modelo, o construye tu propio backend en cualquier lenguaje contra una interfaz abierta
- Drop-in API compatibility: APIs de OpenAI, Anthropic y ElevenLabs en todos los backends
- Any model, any modality: LLMs, visión, voz, imagen y video detrás de una sola API
- Any hardware: NVIDIA, AMD, Intel, Apple Silicon, Vulkan, o solo CPU
- Multi-user ready: autenticación por clave API, cuotas de usuario, acceso basado en roles
- Built-in AI agents: agentes autónomos con uso de herramientas, RAG, MCP y habilidades
- Privacy-first: tus datos nunca abandonan tu infraestructura
Creado por Ettore Di Giacinto y mantenido por el equipo de LocalAI.
:book: Documentación | :speech_balloon: Discord | 💻 Inicio rápido | 🖼️ Modelos | ❓FAQ
Visita guiada
https://github.com/user-attachments/assets/08cbb692-57da-48f7-963d-2e7b43883c18
¡Haz clic para ver más!
Usuario y autenticación
https://github.com/user-attachments/assets/228fa9ad-81a3-4d43-bfb9-31557e14a36c
Agentes
https://github.com/user-attachments/assets/6270b331-e21d-4087-a540-6290006b381a
Métricas de uso por usuario
https://github.com/user-attachments/assets/cbb03379-23b4-4e3d-bd26-d152f057007f
Ajuste fino y cuantización
https://github.com/user-attachments/assets/5ba4ace9-d3df-4795-b7d4-b0b404ea71ee
WebRTC
https://github.com/user-attachments/assets/ed88e34c-fed3-4b83-8a67-4716a9feeb7b
Inicio rápido
macOS
Note: El DMG no está firmado por Apple. Después de instalar, ejecute:
sudo xattr -d com.apple.quarantine /Applications/LocalAI.app. Consulte #6268 para más detalles.
Contenedores (Docker, podman, ...)
¿Ya has ejecutado LocalAI antes? Usa
docker start -i local-aipara reiniciar un contenedor existente.
Solo CPU:
docker run -ti --name local-ai -p 8080:8080 localai/localai:latest
NVIDIA GPU:
# CUDA 13
docker run -ti --name local-ai -p 8080:8080 --gpus all localai/localai:latest-gpu-nvidia-cuda-13

# CUDA 12
docker run -ti --name local-ai -p 8080:8080 --gpus all localai/localai:latest-gpu-nvidia-cuda-12

# NVIDIA Jetson ARM64 (CUDA 12, for AGX Orin and similar)
docker run -ti --name local-ai -p 8080:8080 --gpus all localai/localai:latest-nvidia-l4t-arm64

# NVIDIA Jetson ARM64 (CUDA 13, for DGX Spark)
docker run -ti --name local-ai -p 8080:8080 --gpus all localai/localai:latest-nvidia-l4t-arm64-cuda-13
AMD GPU (ROCm):
docker run -ti --name local-ai -p 8080:8080 --device=/dev/kfd --device=/dev/dri --group-add=video localai/localai:latest-gpu-hipblas
GPU Intel (oneAPI):
docker run -ti --name local-ai -p 8080:8080 --device=/dev/dri/card1 --device=/dev/dri/renderD128 localai/localai:latest-gpu-intel
Vulkan GPU:
docker run -ti --name local-ai -p 8080:8080 localai/localai:latest-gpu-vulkan
Cargando modelos
# From the model gallery (see available models with `local-ai models list` or at https://models.localai.io)
local-ai run llama-3.2-1b-instruct:q4_k_m
# From Huggingface
local-ai run huggingface://TheBloke/phi-2-GGUF/phi-2.Q8_0.gguf
# From the Ollama OCI registry
local-ai run ollama://gemma:2b
# From a YAML config
local-ai run https://gist.githubusercontent.com/.../phi-2.yaml
# From a standard OCI registry (e.g., Docker Hub)
local-ai run oci://localai/phi-2:latest
Para trabajar con un servidor LocalAI en ejecución desde la terminal, inicia el agente integrado desde otro shell. Este responde preguntas, lee tus archivos y ejecuta comandos en tu máquina, pidiéndote que apruebes cualquier acción que modifique el estado. Dentro de una sesión, /models lista los modelos instalados y /model <name> permite cambiar entre ellos. Consulta la documentación del Terminal agent.
# Terminal 1
local-ai run llama-3.2-1b-instruct:q4_k_m

# Terminal 2
local-ai chat --model llama-3.2-1b-instruct:q4_k_m
Detección automática de backend: LocalAI detecta automáticamente las capacidades de tu GPU y descarga el backend adecuado. Para opciones avanzadas, consulta Aceleración por GPU.
Para más detalles, consulta la guía de primeros pasos.
Últimas Noticias
- Octubre de 2026: LocalAI 4.11.0 — Escenas de audio con transcripción, etiquetas de hablante y detección de sonido. También la API de Decisions (
/v1/systemone), cadenas de conmutación por error de modelos, galerías OCI firmadas y Kimodo de texto a animación. Notas de la versión - Septiembre de 2026: LocalAI 4.10.0 — Un panel de operaciones de flota, un único archivo de credenciales para fuentes de modelos privadas y
local-ai benchmarkpara medir la latencia y el rendimiento del modelo. Notas de la versión - Agosto de 2026: LocalAI 4.9.0 — Autenticación con denegación por defecto, compresión del contexto del chat opcional, gestión unificada de modelos y backends, y generación de video con audio de MiniMax-H3. Notas de la versión
- Agosto de 2026: LocalAI 4.8.0 — Presentamos vllm.cpp (compilaciones de desarrollo alfa), generación de imágenes a 3D con un visor integrado y
audio.cpppara habla, transcripción, VAD, diarización, separación de fuentes y generación de sonido. Notas de la versión - Julio de 2026: LocalAI 4.7.0 — Perfiles gestionados de clonación de voz, generación local de video y avatares parlantes, y razonamiento intercalado con llamadas a herramientas. Notas de la versión
- Julio de 2026: LocalAI 4.6.0 — Correcciones de AMD ROCm, calentamiento predecible de la canalización en tiempo real, bifurcación de conversaciones y carga distribuida de modelos más confiable. Notas de la versión
- Junio de 2026: LocalAI 4.5.0 — Estimación de profundidad nativa y detección de eventos sonoros, filtrado de PII basado en NER y conversaciones en tiempo real con reconocimiento de hablante y compactación automática del historial. Notas de la versión
Noticias anteriores
- Junio 2026: Nuevos backends biométricos nativos del equipo de LocalAI: voice-detect.cpp para reconocimiento de hablantes y análisis de voz (ECAPA-TDNN, WeSpeaker, ERes2Net, CAM++, wav2vec2 edad/género/emoción) y face-detect.cpp para detección facial, reconocimiento, datos demográficos y antispoofing (SCRFD/ArcFace, YuNet/SFace). Ambos son motores C++/ggml desarrollados desde cero sin Python ni onnxruntime en inferencia, pesos GGUF autocontenidos, paridad bit exacta con la referencia y paridad GPU cuDNN, reemplazando los backends más pesados de Python
insightfaceyspeaker-recognition(PR #10441). - Junio 2026: Nueva demo de asistente de voz en tiempo real (un pequeño cliente Go para la API en tiempo real con un bucle completo de voz y llamada a herramientas), además de streaming de las etapas del pipeline LLM / TTS / transcripción en tiempo real y candidatos ICE WebRTC configurables.
- Junio 2026: Gran impulso en voz: el motor ASR parakeet.cpp incorpora marcas de tiempo de segmento fieles a NeMo, un modelo Nemotron-3.5 de streaming multilingüe, procesamiento por lotes dinámico para transcripción concurrente y gráficos CUDA; el nuevo backend CrispASR agrega ASR + TTS multiarquitectura, y 60 voces Piper TTS en 42 idiomas llegan a la galería (además de instrucciones y parámetros TTS por solicitud).
- Junio 2026: Nuevos backends y modelos: locate-anything.cpp para detección de objetos de vocabulario abierto mediante ggml, generación de imágenes Ideogram4 en stablediffusion-ggml, entrada de video llama.cpp y la familia Gemma 4 QAT con pares de decodificación especulativa MTP. Además, un modo de chat CLI interactivo y citas de fuentes RAG en respuestas de agentes.
- Junio 2026: Refuerzo del modo distribuido: enrutamiento consciente de caché de prefijo, un enrutador de solicitudes listo para producción con lotes de embedding/rerank de tamaño automático, inferencia distribuida con división de capas ds4, autenticación NATS JWT + TLS/mTLS y cargas de archivos reanudables.
- Mayo 2026: LocalAI 4.3.0 -
llama.cppcaché de prompt activada por defecto (los prompts de sistema repetidos pasan de minutos a segundos), firma cosign sin clave de imágenes OCI de backend, atribución de uso por clave API + por usuario, Distributed v3 con enrutamiento de réplicas por solicitud. Notas de la versión - Mayo 2026: LocalAI 4.2.0 - LocalAI ve y oye: reconocimiento de voz, reconocimiento facial + antispoofing de vivacidad, diarización de hablantes. Además, API compatible con Ollama, generación de video, interfaz de usuario rediseñada con i18n + marca configurable por administrador, vLLM a la par de funciones con llama.cpp y 11 nuevos backends. Notas de la versión
- Abril 2026: LocalAI 4.1.0 - LocalAI se convierte en una torre de control: modo de clúster distribuido con enrutamiento inteligente consciente de VRAM + autoescalado, plataforma multiusuario con OIDC y claves API, cuotas por usuario con análisis predictivo, ajuste fino en la interfaz de usuario con TRL (autoexportación a GGUF), backend de cuantización sobre la marcha, editor visual de pipelines. Notas de la versión
- Marzo 2026: LocalAI 4.0.0 - orquestación agente nativa con el nuevo centro comunitario Agenthub, reescritura completa de la interfaz React con modo Canvas, MCP Apps + lado cliente con streaming de herramientas, audio en tiempo real WebRTC, MLX-distribuido. Notas de la versión
- Febrero 2026: API en tiempo real para audio a audio con llamada a herramientas, soporte para ACE-Step 1.5
- Enero 2026: LocalAI 3.10.0 — Soporte de API Anthropic, Open Responses API, generación de video e imágenes (LTX-2), backends GPU unificados, streaming de herramientas, Moonshine, Pocket-TTS. Notas de la versión
- Diciembre 2025: Reclamador de recursos de memoria dinámica, Ajuste automático de modelos multigpu (llama.cpp), backend Vibevoice
- Noviembre 2025: Importar modelos mediante URL, Múltiples chats e historial
- Octubre 2025: Soporte de Protocolo de Contexto de Modelos (MCP) para capacidades de agente
- Septiembre 2025: Nuevo lanzador para macOS y Linux, soporte ampliado de backends para Mac y Nvidia L4T, MLX-Audio, WAN 2.2
- Agosto 2025: MLX, MLX-VLM, Diffusers, llama.cpp ahora compatibles con Apple Silicon
- Julio 2025: Todos los backends migrados fuera del binario principal — arquitectura ligera y modular
Para noticias anteriores y notas de versión completas, consulte GitHub Releases y el blog.
Características
- Generación de texto (
llama.cpp,transformers,vllm... y más) - Texto a audio
- Audio a texto
- Generación de imágenes
- API de herramientas compatible con OpenAI
- API en tiempo real (Voz a voz)
- Generación de embeddings
- Gramáticas restringidas
- Descargar modelos de Huggingface
- API de visión
- Detección de objetos
- API de reranker
- Inferencia P2P
- Modo distribuido — Escalado horizontal con PostgreSQL + NATS
- Protocolo de contexto de modelo (MCP)
- Agentes integrados — Agentes autónomos de IA con uso de herramientas, RAG, habilidades, transmisión SSE y Agent Hub
- Galería de backends — Instalar/eliminar backends sobre la marcha mediante imágenes OCI
- Detección de actividad de voz (Silero-VAD)
- WebUI integrada
Backends compatibles y aceleración
LocalAI soporta más de 60 backends incluyendo llama.cpp, vLLM, SGLang, transformers, whisper.cpp, diffusers, MLX, MLX-VLM, y muchos más. La aceleración por hardware está disponible para NVIDIA (CUDA 12/13), AMD (ROCm), Intel (oneAPI/SYCL), Apple Silicon (Metal), Vulkan, y NVIDIA Jetson (L4T). Todos los backends se pueden instalar sobre la marcha desde la Galería de Backends.
Consulte la Tabla de compatibilidad de Backend y Modelos y la guía de Aceleración por GPU.
Backends creados por nosotros
La mayoría de los backends envuelven un motor upstream de primera clase. Un puñado de ellos son motores nativos en C/C++/GGML (sin Python en la inferencia) desarrollados y mantenidos por el propio proyecto LocalAI:
| Backend | Qué hace |
|---|---|
| vllm.cpp | Port desde cero a C++20 de vLLM para generación de texto: caché KV paginada, batching continuo, caché de prefijos, carga de safetensors + GGUF, salida estructurada forzada por el motor, en CPU, CUDA, Metal y Vulkan. También sirve para la generación conjunta de video+audio de MiniMax-H3 |
| parakeet.cpp | Port a C++/GGML de NVIDIA NeMo Parakeet ASR (tdt/ctc/rnnt/hybrid), con transcripción en streaming consciente de la caché |
| moss-transcribe.cpp | Port a C++/GGML de OpenMOSS MOSS-Transcribe-Diarize: transcripción conjunta de formato largo, diarización de hablantes y marcas de tiempo en una sola pasada |
| moss-tts.cpp | Port a C++/GGML de la familia OpenMOSS MOSS-TTS: texto a voz (MOSS-TTS-Local v1.5, 48 kHz estéreo) con clonación de voz por audio de referencia, a través del códec neuronal MOSS-Audio-Tokenizer |
| magpie-tts.cpp | Port a C++/GGML de Magpie TTS Multilingual 357M de NVIDIA: texto a voz mono a 22.05 kHz en 5 voces y más de 9 idiomas, con el códec neuronal NanoCodec y el tokenizador/G2P integrados en un único GGUF |
| ced.cpp | Port a C++/GGML de los modelos de etiquetado de audio CED: clasificación de eventos sonoros (AudioSet de 527 clases) sobre REST y la API en tiempo real para reconocimiento en vivo |
| voice-detect.cpp | Reconocimiento de hablantes y análisis de voz (ECAPA-TDNN, WeSpeaker, ERes2Net, CAM++, edad/género/emoción con wav2vec2), en reemplazo del backend de reconocimiento de hablantes en Python |
| voxtral-tts.c | Texto a voz Mistral Voxtral-4B-TTS en C puro: 20 voces predefinidas en 9 idiomas, salida WAV a 24 kHz, sin dependencias más allá de libc |
| vibevoice.cpp | Port nativo de Microsoft VibeVoice para TTS (clonación de voz) y ASR de formato largo con diarización de hablantes |
| rf-detr.cpp | Detección de objetos y segmentación de instancias nativa de RF-DETR |
| locate-anything.cpp | Detección de objetos de vocabulario abierto y anclaje visual (LocateAnything-3B) |
| depth-anything.cpp | Profundidad métrica monocular Depth Anything 3 + estimación de pose de cámara |
| face-detect.cpp | Detección de rostros, reconocimiento, demografía y anti-spoofing (SCRFD/ArcFace, YuNet/SFace), en reemplazo del backend insightface en Python |
| free-splatter.cpp | Reconstrucción 3D sin pose (FreeSplatter): convierte un puñado de fotos simples en Gaussianas 3D, sin necesidad de poses de cámara ni GPU |
| trellis2.cpp | Port a C++/GGML de Microsoft TRELLIS.2: de imagen única a malla 3D texturizada (GLB con materiales PBR) |
| kimodo.cpp | Texto a movimiento en C++/GGML sobre CPU y Vulkan, exportado como esqueleto animado GLB |
| privacy-filter.cpp | Motor de clasificación de tokens PII/NER en GGML independiente que impulsa el nivel de redacción de PII de LocalAI |
| LocalVQE | Cancelación conjunta de eco acústico, supresión de ruido y desreverberación |
| local-store | Base de datos vectorial local-first para embeddings (incluida en el árbol de código) |
También mantenemos apex-quant, una receta de cuantización por tensor y por capa para modelos de Mezcla de Expertos que aprovecha su dispersión estructural para producir GGUFs que igualan o superan la calidad de Q8_0, y funcionan sin configuración adicional en llama.cpp estándar.
Recursos
- Documentación
- Guía de ajuste fino de LLM
- Compilar desde el código fuente
- Instalación en Kubernetes
- Integraciones y proyectos de la comunidad
- Videotutorial de instalación
- Blog: notas de versiones, benchmarks y notas de ingeniería
- Ejemplos — incluida la demo de asistente de voz en tiempo real (cliente Go para la API Realtime con llamada a herramientas)
Equipo
LocalAI es mantenido por un pequeño equipo de personas, junto con la amplia comunidad de colaboradores.
- Ettore Di Giacinto — autor original y líder del proyecto
- Richard Palethorpe — mantenedor
Un enorme agradecimiento a todos los que contribuyen código, revisan PRs, reportan problemas y ayudan a los usuarios en Discord — LocalAI es un proyecto impulsado por la comunidad y no existiría sin ustedes. Vea la lista completa de contribuidores.
Cita
Si utiliza este repositorio o sus datos en un proyecto derivado, por favor considere citarlo con:
@misc{localai,
  author = {Ettore Di Giacinto},
  title = {LocalAI: The free, Open source OpenAI alternative},
  year = {2023},
  publisher = {GitHub},
  journal = {GitHub repository},
  howpublished = {\url{https://github.com/go-skynet/LocalAI}},
Patrocinadores
¿Encuentras útil LocalAI?
Apoya el proyecto convirtiéndote en colaborador o patrocinador. Tu logotipo aparecerá aquí con un enlace a tu sitio web.
Un enorme agradecimiento a nuestros generosos patrocinadores que apoyan este proyecto cubriendo los gastos de CI, y nuestra lista de patrocinadores:
Patrocinadores anteriores
Patrocinadores individuales
Un agradecimiento especial a los patrocinadores individuales; la lista completa está en GitHub y buymeacoffee. Un agradecimiento especial a drikster80 por su generosidad. ¡Gracias a todos!
Licencia
LocalAI es un proyecto impulsado por la comunidad creado por Ettore Di Giacinto y mantenido por el equipo de LocalAI.
MIT - Autor Ettore Di Giacinto [email protected]
Agradecimientos
LocalAI no podría haber sido construido sin la ayuda de excelente software ya disponible de la comunidad. ¡Gracias!
- llama.cpp
- https://github.com/tatsu-lab/stanford_alpaca
- https://github.com/cornelk/llama-go para las ideas iniciales
- https://github.com/antimatter15/alpaca.cpp
- https://github.com/EdVince/Stable-Diffusion-NCNN
- https://github.com/ggerganov/whisper.cpp
- https://github.com/rhasspy/piper
- exo para la implementación de fragmentación paralela automática distribuida MLX
Colaboradores
¡Este es un proyecto comunitario, un agradecimiento especial a nuestros contribuidores!